
蚂蚁百灵发布 Ling 3.2 Flash:560B 总参、每次只激活 25B,官方榜单称三项基准超 Claude Opus 5
作者:陈一帆
11 月 6 日,蚂蚁百灵团队上线原生多模态模型 Ling-3.2-flash:总参数 560B、激活参数约 25B、上下文窗口 1M,可输入图像、文本和视频,API 已开放并兼容 OpenAI 与 Anthropic 协议,上线前两周限时免费。官方自测在三项基准上超过 Claude Opus 5,但成绩来自厂商榜单,暂无第三方复测;免费期截止日与后续价格细节也尚未明确。
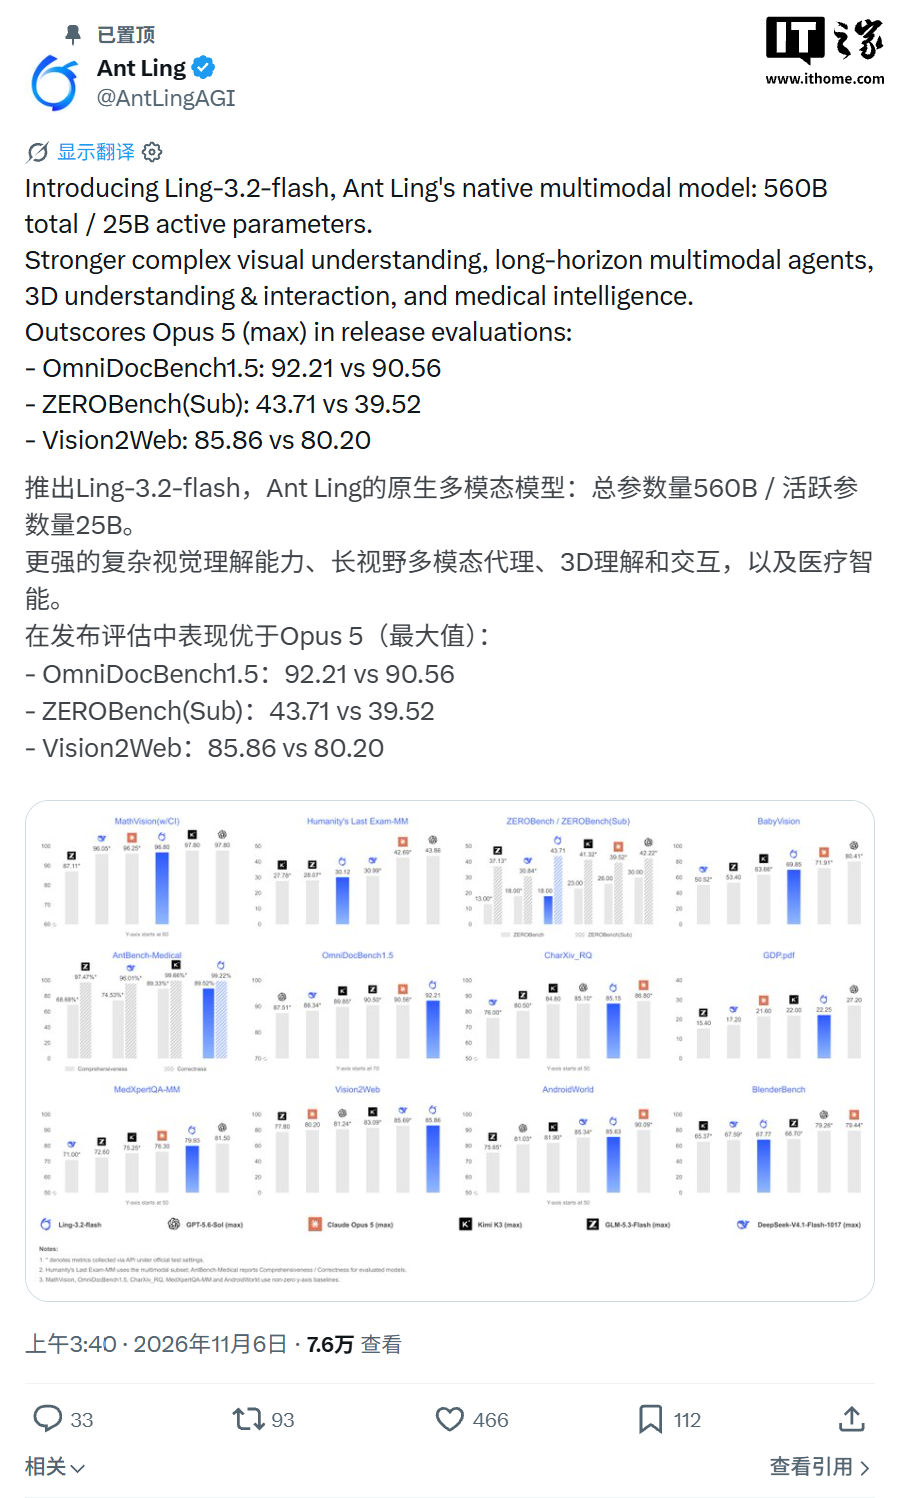
11 月 6 日,蚂蚁百灵团队上线原生多模态模型 Ling-3.2-flash:总参数 560B,每次推理激活约 25B,上下文窗口 1M 词元,支持图像、文本、视频三类输入。API 已在蚂蚁百灵平台开放,兼容 OpenAI 与 Anthropic 两种调用协议,上线前两周限时免费 。
先把两个数字说清楚。
总参数 560B、激活 25B,可以理解成一个 560 人的大部门:知识都写在每个人的工位上,但每来一个任务只叫 25 个人上场处理。这样存的东西多,单步计算的开销却被压下来。这种「总参大、激活小」的做法通常对应混合专家(MoE)架构,也是它能在能力与推理成本之间做平衡的原因 。
1M 上下文窗口,相当于一次能读完几百页的项目资料,翻到最后一页时还记得第一页定下的结论。对需要来回翻材料、跨多步做判断的 Agent 来说,这是能干活的基础条件,而不只是参数表上的一个数字。
能力上,官方给了四个重点方向 :
- 复杂视觉理解:对图像和视频做深度推理与分析,不是只识别出画面里有什么
- 多模态长程 Agent:多步任务中持续盯住目标,基于视觉和文本信息做决策与执行
- 3D 理解与交互:解析三维场景与空间关系
- 医疗多模态:覆盖医学影像理解与报告解读,定位在辅助专业分析
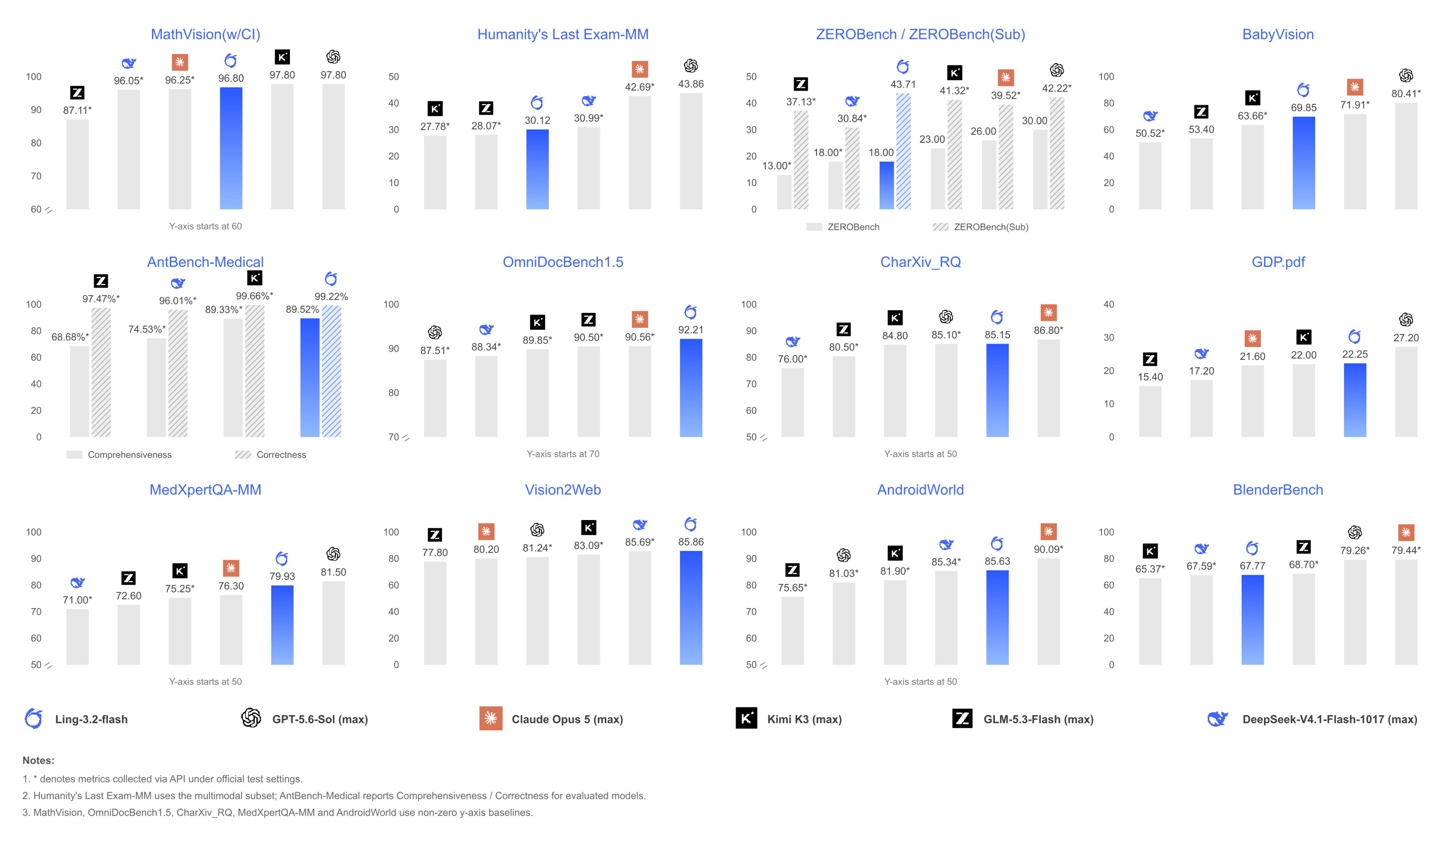
架构层面,官方强调视觉与语言是原生融合,而不是给语言模型外挂一个视觉编码器再拼接起来。这条路线的差别体现在具体任务上:文档版面解析、网页截图还原成前端代码这类活,需要同时看懂空间布局和文字语义,拼接式架构容易在中间环节丢信息 。
「超 Claude Opus 5」这句话需要保留疑问。 三项基准成绩都来自蚂蚁官方公布的评测结果 :OmniDocBench1.5 得 92.21,对比 90.56;ZEROBench(Sub)得 43.71,对比 39.52;Vision2Web 得 85.86,对比 80.20。目前没有看到第三方对这些结果的独立复测,测试子集和提示词口径也未公开,对比用的具体是 Claude Opus 5 的哪个档位,同样只有转述。这属于「官方榜单上领先」,还不能说成「实际使用中更强」。
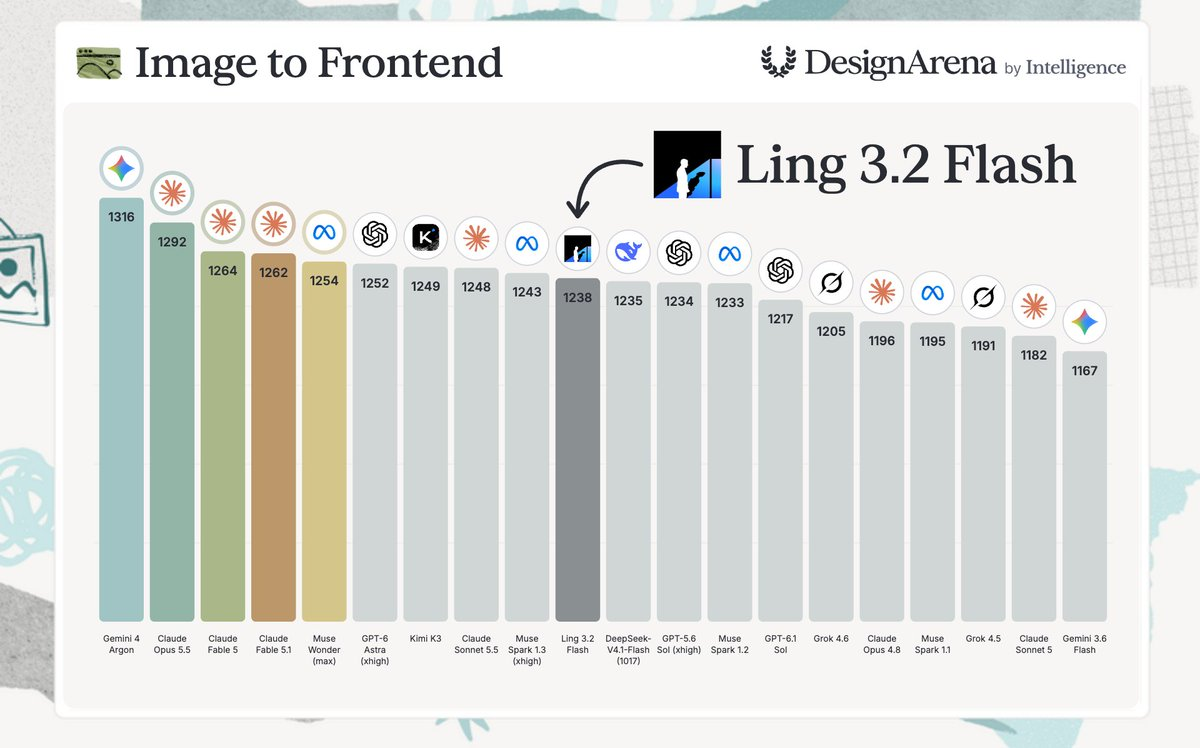
另一项成绩来自 DesignArena 图像转前端竞技场:1238 的 Elo 分数进入前十,与 Meta、DeepSeek、Anthropic 的模型并列 。竞技场是人类投票排名,和固定题库的基准测试是两套评判标准,不宜放在一起做比较。
价格方面,API 输入每百万词元 0.30 美元(约合 2 元人民币),输出每百万词元 0.90 美元(约合 6 元人民币)。「同性能级别最低费率」这个说法出自 DesignArena 榜单,「同性能级别」怎么划档并未说明,所以它更接近宣传表述,而不是可独立验证的结论 。
实际影响:如果你手上有文档解析、截图转页面、多步视觉操作这类需求,两周免费期是成本很低的试错窗口。建议直接拿自己最典型的材料去测试:一段几十页的 PDF、一段长视频、一个需要跨十几步操作的任务,看它在长上下文里会不会中途忘掉前面定下的条件。医疗方向的产品则建议先等官方补齐合规边界和适用范围的说明再评估,影像解读涉及监管要求,模型能力只是其中一环。
还有几件事待确认:三项基准有无第三方复测;免费期的确切截止日和到期后的正式价格、限流与并发限制;权重是否开源;发布信息目前只依赖单一转述来源,核心数字应以官方后续公布为准。
转载说明
本文根据以下公开资料整理,原文及配图出处见下方。
- [S1] 蚂蚁百灵大模型 Ling 3.2 Flash 发布:三项基准超越 Claude Opus 5,前两周限时免费
- 配图 1:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 2:来源:www.ithome.com(图片署名见原文) · 图片出处
- 配图 3:来源:www.ithome.com(图片署名见原文) · 图片出处
评论 0
还没有评论,来抢沙发。